> For the complete documentation index, see [llms.txt](https://navixy.com/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://navixy.com/docs/analytics/es/iot-query/schema-overview/transformation-layer/common-transformations/sensor-data-aggregation.md).

# Agregación de Datos del sensor

Procese lecturas brutas de sensores de IoT en registros por hora agrupados por intervalo de tiempo, con calibración decodificada, cálculos de Volumen de combustible y agregación a nivel de dispositivo

La transformación de agregación de Datos del sensor vuelve a muestrear las lecturas sin procesar del sensor en registros de resumen agrupados por intervalo de tiempo. Cada fila en `processed_common_data.sensors_data_by_hours` representa un sensor en un dispositivo para un intervalo: el valor decodificado promedio, mínimo y máximo, y, para sensores de combustible, el volumen calibrado en cada uno de esos puntos.

La transformación integrada se ejecuta cada hora y agrega la última hora de Datos del sensor sin procesar de `raw_telematics_data.inputs` en intervalos de una hora. Cada ejecución agrega al final un nuevo conjunto de registros horarios a la tabla.

{% hint style="info" %}
Los datos de esta tabla pueden tener hasta 1 hora de antigüedad, lo que refleja la ejecución completada más recientemente.\
Todas las marcas de tiempo se almacenan en UTC.\
Solo los valores numéricos de los sensores participan en la agregación. Los estados de texto, los números negativos y la notación científica se filtran en el origen.
{% endhint %}

### Tabla de salida: processed\_common\_data.sensors\_data\_by\_hours

Cada fila representa un intervalo de lecturas agregadas para un sensor en un dispositivo. En la transformación integrada, cada intervalo abarca una hora. La clave natural es `hour_bucket`, `device_id`, `sensor_name`, y `event_id`.

<table><thead><tr><th width="245">Campo</th><th width="115">Tipo</th><th>Descripción</th></tr></thead><tbody><tr><td><code>hour_bucket</code></td><td>marca de tiempo</td><td>Inicio del intervalo de tiempo que agrupa la fila. En la transformación integrada, siempre alineado con el límite de la hora en UTC. En transformaciones personalizadas con un tamaño de intervalo diferente, este es el inicio del intervalo con la granularidad elegida (por ejemplo, el inicio de una ventana de 5 minutos).</td></tr><tr><td><code>device_id</code></td><td>entero</td><td>Identificador del dispositivo. Para obtener la etiqueta del objeto sin multiplicar filas, únase a <code>raw_business_data.objects</code> activado <code>device_id</code> donde <code>is_deleted = false</code>.</td></tr><tr><td><code>sensor_name</code></td><td>texto</td><td>Identificador de entrada sin procesar de <code>raw_telematics_data.inputs</code>Coincide con <code>sensor_description.input_label</code> cuando un sensor está configurado.</td></tr><tr><td><code>event_id</code></td><td>entero</td><td>Identificador del tipo de evento para la lectura del sensor.</td></tr><tr><td><code>sensor_id</code></td><td>entero</td><td>Identificador de entidad del sensor de <code>raw_business_data.sensor_description</code>. Nulo si el sensor no está configurado.</td></tr><tr><td><code>input_label</code></td><td>texto</td><td>Etiqueta de entrada configurada desde <code>sensor_description</code>Coincide con <code>sensor_name</code> cuando está presente.</td></tr><tr><td><code>sensor_label</code></td><td>texto</td><td>Nombre del sensor legible para humanos definido por el usuario.</td></tr><tr><td><code>sensor_type</code></td><td>texto</td><td>Tipo de sensor, por ejemplo <code>nivel_de_combustible</code>, <code>temperatura</code>, <code>ignición</code>.</td></tr><tr><td><code>unidades del sensor</code></td><td>texto</td><td>Cadena de unidad ingresada por el usuario cuando <code>units_type</code> está configurado como personalizado. De lo contrario, está vacío.</td></tr><tr><td><code>units_type</code></td><td>entero</td><td>Código numérico de la categoría de la unidad. Se resuelve en una cadena legible por humanos en <code>sensor_description_units_type</code>.</td></tr><tr><td><code>Tipo de Grupo</code></td><td>entero</td><td>Código de regla de agregación para sensores agrupados: 0 para suma, 1 para promedio. Resuelto en <code>tipo de Grupo de descripción del sensor</code>.</td></tr><tr><td><code>value_avg</code></td><td>flotante</td><td>Promedio del valor decodificado del sensor entre todas las lecturas en el segmento.</td></tr><tr><td><code>value_min</code></td><td>flotante</td><td>Valor mínimo decodificado en el segmento.</td></tr><tr><td><code>value_max</code></td><td>flotante</td><td>Valor máximo decodificado en el segmento.</td></tr><tr><td><code>val_low_avg</code>, <code>val_high_avg</code>, <code>vol_low_avg</code>, <code>vol_high_avg</code></td><td>numeric</td><td>Puntos de calibración usados al interpolar <code>calibrated_volume_avg</code>. Solo para sensores de Combustible; nulo en caso contrario.</td></tr><tr><td><code>calibrated_volume_avg</code></td><td>numeric</td><td>Volumen calibrado correspondiente a <code>value_avg</code>, calculado mediante interpolación lineal entre los puntos de calibración. Para sensores que no son de Combustible, esto equivale a <code>value_avg</code>.</td></tr><tr><td><code>val_low_min</code>, <code>val_high_min</code>, <code>vol_low_min</code>, <code>vol_high_min</code>, <code>calibrated_volume_min</code></td><td>numeric</td><td>Puntos de calibración y volumen interpolado para <code>value_min</code>.</td></tr><tr><td><code>valor_bajo_máximo</code>, <code>val_high_max</code>, <code>vol_low_max</code>, <code>vol_high_max</code>, <code>volumen_calibrado_máximo</code></td><td>numeric</td><td>Puntos de calibración y volumen interpolado para <code>value_max</code>.</td></tr><tr><td><code>etiqueta de objeto</code></td><td>texto</td><td>Etiqueta de Objeto de <code>raw_business_data.objects</code>. Puede aparecer varias veces para el mismo bucket si un dispositivo fue reasignado entre objetos históricamente.</td></tr><tr><td><code>sensor_description_units_type</code></td><td>texto</td><td>Categoría de unidad legible para humanos resuelta a partir de <code>units_type</code>.</td></tr><tr><td><code>tipo de Grupo de descripción del sensor</code></td><td>texto</td><td>Regla de agrupación legible para humanos resuelta a partir de <code>Tipo de Grupo</code>.</td></tr><tr><td><code>sensor_units_final</code></td><td>texto</td><td>La cadena de la unidad que se mostrará. Es igual a <code>unidades del sensor</code> cuando está definido; de lo contrario, recurre a <code>sensor_description_units_type</code>.</td></tr><tr><td><code>value_title</code></td><td>texto</td><td>Etiqueta legible para humanos de los sensores discretos, consultada en <code>parameters.value_titles</code> usando <code>value_max</code> como la clave. Null para Sensores de medición.</td></tr></tbody></table>

Los ejemplos a continuación muestran patrones de consulta comunes. El primero devuelve agregados por hora de los últimos 7 días. El segundo hace join con `raw_business_data.objects` para incluir la etiqueta del Objeto sin multiplicación de filas. La tercera se centra en sensores de Combustible y usa las columnas de volumen calibrado.

{% tabs %}
{% tab title="Consulta horaria básica" %}
{% code overflow="wrap" expandable="true" %}

```sql
SELECT
    device_id,
    hour_bucket,
    sensor_label,
    sensor_type,
    value_avg,
    value_min,
    value_max,
    sensor_units_final
FROM processed_common_data.sensors_data_by_hours
WHERE hour_bucket >= CURRENT_DATE - INTERVAL '7 days'
ORDER BY device_id, hour_bucket, sensor_label;
```

{% endcode %}
{% endtab %}

{% tab title="Con etiqueta de Objeto" %}
{% code overflow="wrap" expandable="true" %}

```sql
SELECT
    s.device_id,
    o.object_label,
    s.hour_bucket,
    s.sensor_label,
    s.value_avg,
    s.sensor_units_final
FROM processed_common_data.sensors_data_by_hours s
LEFT JOIN raw_business_data.objects o
    ON o.device_id = s.device_id
   AND o.is_deleted = false
WHERE s.hour_bucket >= CURRENT_DATE - INTERVAL '7 days'
ORDER BY s.device_id, s.hour_bucket, s.sensor_label;
```

{% endcode %}
{% endtab %}

{% tab title="Sensores de combustible con volumen calibrado" %}
{% code overflow="wrap" expandable="true" %}

```sql
SELECT
    device_id,
    hour_bucket,
    sensor_label,
    value_avg AS raw_avg,
    calibrated_volume_avg AS volume_avg_litres,
    calibrated_volume_min AS volume_min_litres,
    calibrated_volume_max AS volume_max_litres
FROM processed_common_data.sensors_data_by_hours
DONDE sensor_type = 'fuel_level'
  AND hour_bucket >= CURRENT_DATE - INTERVAL '24 hours'
ORDER BY device_id, hour_bucket;
```

{% endcode %}
{% endtab %}
{% endtabs %}

### Cómo se construyen los agregados de sensores

Una fila en esta tabla no es una lectura sin procesar del dispositivo; es una entidad derivada ensamblada a partir de muchas lecturas individuales de sensores. La transformación trabaja con los Datos brutos por etapas: decidir qué lecturas son utilizables, vincular la configuración del sensor, decodificar el valor, agruparlo en ventanas de tiempo, agregarlo, aplicar la calibración de Combustible y, por último, enriquecerlo con etiquetas legibles por humanos. Entender este proceso le ayuda a interpretar correctamente los resultados y a reconocer cuándo el comportamiento predeterminado necesita ajustes para su caso de uso.

Estos son los pasos del algoritmo que forma una fila de agregado de sensores:

{% stepper %}
{% step %}

#### **Lectura y filtrado de entradas sin procesar**

La transformación lee el fragmento más reciente de datos de `raw_telematics_data.inputs`. La longitud del fragmento coincide con el intervalo configurado: la ejecución integrada lee la última hora; una ejecución personalizada con un intervalo de 5 minutos lee los últimos 5 minutos. Las lecturas se filtran antes de cualquier procesamiento adicional:

* Solo los valores que coinciden con la expresión regular `^[0-9]+\.?[0-9]*$` pasan a través. Esto acepta enteros y decimales no negativos.
* Se excluyen los valores de texto, los números negativos, la notación científica y los valores nulos.
* Los sensores que emiten solo datos no numéricos no aparecen en la tabla de salida.

El filtro opera sobre el valor en bruto `value` columna en `entradas`, antes de que se aplique cualquier decodificación.
{% endstep %}

{% step %}

#### **Configuración de unión de sensores**

Cada lectura restante se compara con `raw_business_data.sensor_description` mediante un `LEFT JOIN` activado `device_id` y `input_label = sensor_name`. La unión incorpora `sensor_id`, `sensor_label`, `sensor_type`, `units_type`, `Tipo de Grupo`, `divider`, `multiplier`, `calibration_data`, y `parámetros`. Como la unión es del lado izquierdo, las lecturas de los sensores no configurados siguen pasando con los metadatos del sensor en null.
{% endstep %}

{% step %}

#### **Decodificación del valor sin procesar**

Cada lectura se convierte de su representación almacenada a un valor numérico utilizable. La regla de decodificación proviene de `sensor_description.parameters.calc_method`:

* `bit_index` extrae un solo bit del valor entero usando desplazamiento de bits y máscara: `((raw_value::bigint >> bit_index) & 1)`. Se usa para banderas de estado empaquetadas en enteros.
* `identity` usa el valor numérico bruto sin cambios.
* De lo contrario, la función aplica `(raw_value / divider) * multiplier`, que es la fórmula estándar para Sensores de medición. Un divisor nulo activa un `COALESCE` de respaldo al valor bruto.
  {% endstep %}

{% step %}

#### **Agrupación y agregación**

Los valores decodificados se agrupan en intervalos de tiempo al truncarlos `device_time` hasta el límite del intervalo. Dentro de cada intervalo, la función calcula `AVG`, `MIN`, y `MAX` del valor decodificado. La agrupación también incluye columnas de metadatos del sensor, por lo que los agregados se calculan por sensor, por dispositivo y por intervalo.

En la transformación integrada, el intervalo es de una hora. Las transformaciones personalizadas pueden usar cualquier intervalo positivo. Consulte [Personalizar la transformación](https://claude.ai/chat/32cacafe-fe34-476d-b7d0-c93b4ce82da6#customizing-the-transformation) a continuación.
{% endstep %}

{% step %}

#### **Calibración para sensores de Combustible**

Los sensores con un `calibration_data` arreglo poblado (normalmente sensores de nivel de Combustible) reciben interpolación lineal aplicada a cada agregado. Para `value_avg`, `value_min`, y `value_max` cada uno por separado, la función encuentra los puntos de calibración justo por debajo y justo por encima del valor, y luego interpola linealmente para producir `calibrated_volume_avg`, `calibrated_volume_min`, y `volumen_calibrado_máximo`. Para los sensores sin datos de calibración, los volúmenes calibrados son iguales a los agregados brutos.

Las columnas de puntos de ruptura (`val_low_*`, `val_high_*`, `vol_low_*`, `vol_high_*`) se conservan en la salida para brindar transparencia.
{% endstep %}

{% step %}

#### **Enriquecimiento con etiquetas**

Las filas agregadas se unen con `raw_business_data.objects` activado `device_id` para agregar `etiqueta de objeto`, y con `raw_business_data.description_parameters` dos veces para resolver `units_type` y `Tipo de Grupo` en cadenas de descripción legibles para humanos. La función también calcula `sensor_units_final`, que prefiere el valor ingresado por el usuario `unidades del sensor` y recurre a la cadena de descripción como respaldo.

Para los sensores discretos con un `parameters.value_titles` mapeo, la función busca el título legible para humanos correspondiente a `value_max` y lo devuelve como `value_title`. Los Sensores de medición tienen `value_title` establecido en null.
{% endstep %}
{% endstepper %}

Las dos secciones de referencia siguientes contienen el parámetro de intervalo configurable y las reglas de decodificación que la transformación aplica internamente.

<details>

<summary>Parámetro de intervalo</summary>

La transformación se rige por un solo parámetro, `p_interval`, que controla tanto el tamaño del bucket como la ventana retrospectiva. Ambos siempre son iguales: una ejecución con `p_interval = '5 minutes'` lee los últimos 5 minutos de Datos brutos y genera buckets de 5 minutos.

| Configuración              | Transformación integrada                  | Transformación personalizada                                                     |
| -------------------------- | ----------------------------------------- | -------------------------------------------------------------------------------- |
| Tamaño del bucket          | 1 hora                                    | Cualquier intervalo positivo configurado en el Nodo de SQL personalizado         |
| Ventana retrospectiva      | 1 hora                                    | Igual al tamaño del bucket                                                       |
| Frecuencia de programación | Cada hora (ajustada al tamaño del bucket) | Coincida con el tamaño del bucket elegido para una cobertura continua sin huecos |

Vea [Personalizar la transformación](#customizing-the-transformation) para ver instrucciones sobre cómo cambiar el intervalo.

</details>

<details>

<summary>Reglas de decodificación de valores</summary>

Los valores brutos del sensor llegan como texto en `raw_telematics_data.inputs.value`. La transformación aplica una regla de decodificación basada en la configuración de cada sensor antes de la agregación.

| `calc_method`              | Comportamiento de decodificación                                                                               |
| -------------------------- | -------------------------------------------------------------------------------------------------------------- |
| `bit_index`                | Extrae un solo bit: `((value::bigint >> bit_index) & 1)`. El `bit_index` se lee de `parámetros`.               |
| `identity`                 | Usa el valor bruto como un flotante, sin cambios.                                                              |
| (predeterminado / ninguno) | Aplica `(raw_value / divider) * multiplier`. Un divisor nulo provoca un `COALESCE` de respaldo al valor bruto. |

La interpolación de calibración, aplicada después de la agregación para sensores con datos de calibración, funciona encontrando los puntos de quiebre en `calibration_data` (un arreglo JSONB de `{in, out}` entradas) más cercanos al valor agregado e interpolando linealmente entre ellos. El resultado se almacena en las `calibrated_volume_*` columnas.

</details>

### Personalizar la transformación

La agregación predeterminada de Datos del sensor refleja la agregación horaria de propósito general de Navixy. Si su escenario operativo requiere una granularidad diferente, como una resolución más fina para tableros de diagnóstico o intervalos más amplios para reportes a largo plazo, puede crear una transformación personalizada que llame a `select_timeperiod_sensor_data` con un intervalo diferente y escribe el resultado en su propia tabla en `processed_custom_data`.

La personalización es un cambio de una línea dentro de un Nodo de SQL personalizado:

```sql
SELECT * FROM processed_common_data.select_timeperiod_sensor_data('5 minutes')
```

Cambie el literal del intervalo para controlar tanto el tamaño del bucket como la ventana retrospectiva. La función devuelve la misma estructura de columnas independientemente del intervalo, por lo que la configuración del Nodo de salida posterior sigue siendo sencilla.

{% hint style="warning" %}
El valor del intervalo controla juntos el tamaño del bucket y la ventana retrospectiva. No se pueden configurar de forma independiente. La programación del flujo de trabajo debe ejecutarse al menos con la misma frecuencia que el intervalo; de lo contrario, algunas lecturas no se agregarán.
{% endhint %}

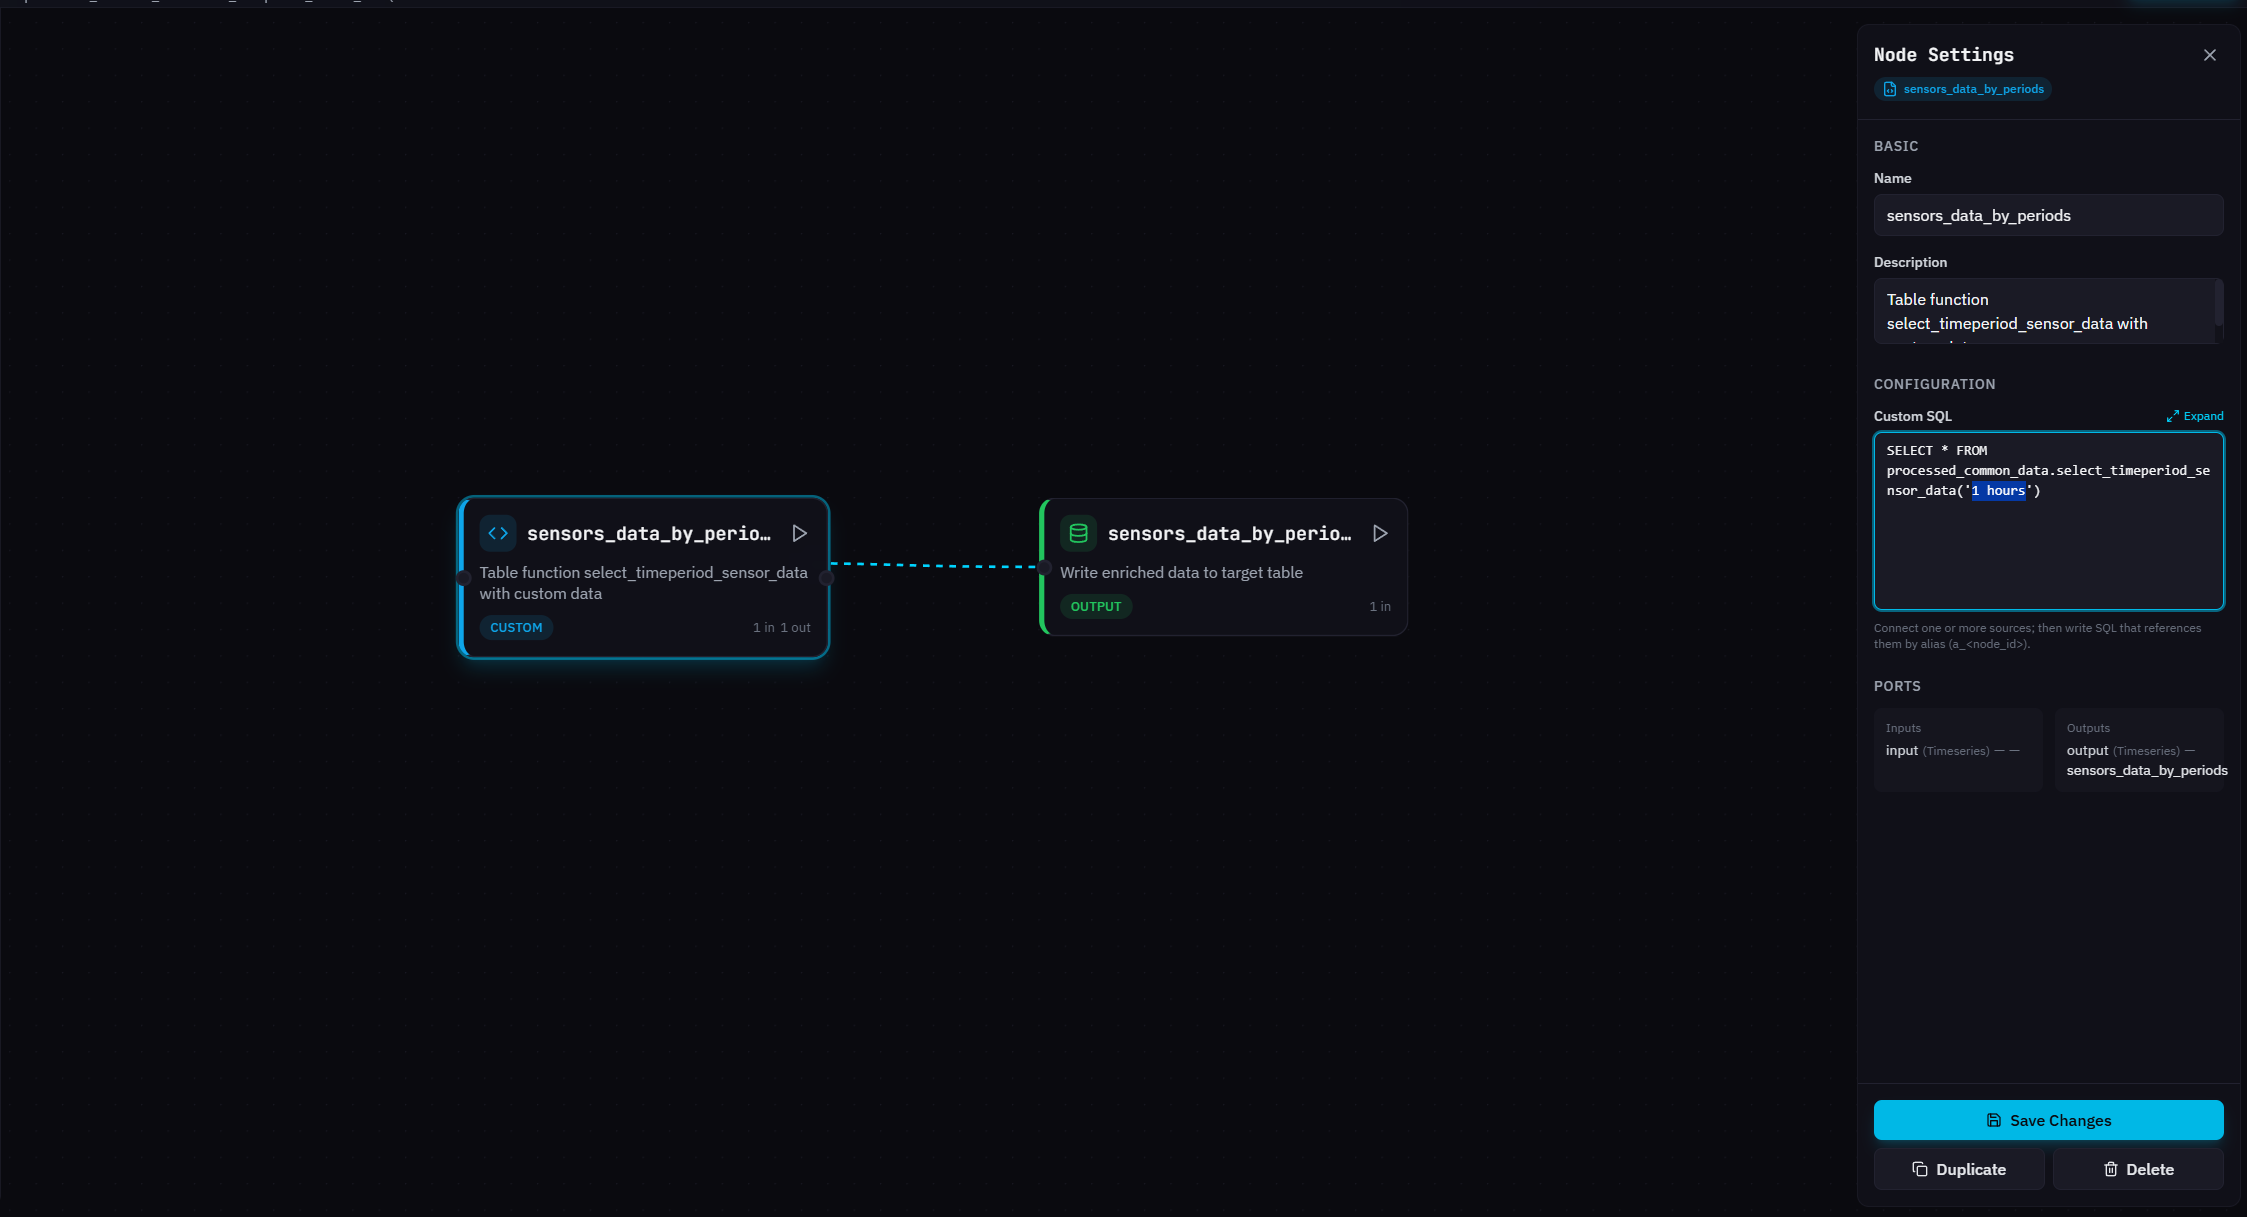
#### Estructura del flujo de trabajo

El flujo de trabajo mínimo consta de dos nodos:

<figure><img src="https://3863334083-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FoFNFEIINiGFbhi3Px3dE%2Fuploads%2Fgit-blob-2160d1986b61ca2e36061e3889caf87b1a905d59%2FSensor-data-aggregation-custom-timeframe.png?alt=media" alt=""><figcaption></figcaption></figure>

No `Datos brutos: Telemática` se necesita ningún nodo fuente. La función lee de `raw_telematics_data.inputs` y `raw_business_data` tablas internamente. El Nodo de SQL personalizado contiene toda la canalización y el Nodo de salida materializa el resultado en su tabla de destino.

#### Ejemplos de personalización

Expanda las secciones a continuación para ver ejemplos de personalización basados en casos.

<details>

<summary>Cambiar el tamaño del bucket</summary>

Úselo cuando la granularidad por hora sea demasiado gruesa para sus necesidades de reporte. Los casos comunes incluyen paneles que muestran tendencias de combustible con resolución de 5 minutos, diagnósticos segundo a segundo para pruebas de manejo cortas y acumulados diarios para reportes de largo plazo.

Para cambiar el tamaño del bloque, edite el literal del intervalo en el Nodo de SQL personalizado y actualice la programación para que coincida.

* **Bloques de 5 minutos**, con programación `*/5 * * * *` (cada 5 minutos):

```sql
SELECT * FROM processed_common_data.select_timeperiod_sensor_data('5 minutes')
```

* **Bloques de 15 minutos**, con programación `*/15 * * * *` (cada 15 minutos):

```sql
SELECT * FROM processed_common_data.select_timeperiod_sensor_data('15 minutes')
```

* **Bloques diarios**, con programación `5 0 * * *` (todos los días a las 00:05 UTC):

```sql
SELECT * FROM processed_common_data.select_timeperiod_sensor_data('1 day')
```

La columna de salida sigue llamándose `hour_bucket` independientemente del intervalo. Si desea un nombre más claro en su tabla personalizada, asígnele un alias en el SQL personalizado:

```sql
SELECT
    hour_bucket AS bucket_time,
    device_id, sensor_name, event_id,
    sensor_id, input_label, sensor_label,
    sensor_type, sensor_units, units_type, Grupo_type,
    valor promedio, valor mínimo, valor máximo,
    etiqueta del objeto, unidades finales del sensor
FROM processed_common_data.select_timeperiod_sensor_data('5 minutes')
```

Establezca el nodo de salida **Columna de tiempo** a `bucket_time` si usa un alias, o a `hour_bucket` si conserva el nombre original.

</details>

<details>

<summary>Restringir a sensores específicos</summary>

Use esto cuando solo necesite agregados para un subconjunto de sensores, por ejemplo solo nivel de combustible y temperatura del motor, para reducir el tamaño de la tabla y el costo de consulta.

Envuelva la llamada a la función en un filtro `SELECT` dentro del nodo SQL personalizado:

```sql
SELECT *
FROM processed_common_data.select_timeperiod_sensor_data('15 minutes')
DONDE sensor_type EN ('fuel_level', 'temperature')
```

Puede filtrar por cualquier columna que devuelve la función, incluyendo `sensor_label`, `sensor_name`, o `sensor_id`. Para encontrar los valores disponibles en sus datos, consulte la tabla de origen:

```sql
SELECT DISTINCT sensor_name FROM raw_telematics_data.inputs LIMIT 100;
```

</details>

<details>

<summary>Reducir la salida a columnas esenciales</summary>

Use esto cuando no necesite los puntos de calibración ni el sensor discreto `value_title` columna, y desea una tabla de salida más compacta. Esto es especialmente útil cuando su Flota no tiene sensores de Combustible, en cuyo caso las 15 columnas relacionadas con la calibración son todas nulas o duplicados de los agregados sin procesar.

Proyecte solo las columnas que necesita:

```sql
SELECT
    hour_bucket,
    device_id,
    nombre_del_sensor,
    event_id,
    sensor_label,
    sensor_type,
    value_avg,
    value_min,
    value_max,
    etiqueta_del_objeto,
    sensor_units_final
FROM processed_common_data.select_timeperiod_sensor_data('15 minutes')
```

La configuración del Nodo de salida seguirá siendo la misma; la tabla de destino simplemente tendrá menos columnas.

</details>

#### Configuración del Nodo de salida

Una vez que el Nodo de SQL personalizado esté configurado, conéctelo a un Nodo de salida y configure la tabla de destino.

<table><thead><tr><th width="180">Parámetro</th><th>Valor</th></tr></thead><tbody><tr><td><strong>Nombre de la tabla</strong></td><td>Un nombre descriptivo, por ejemplo <code>sensors_data_by_5min</code></td></tr><tr><td><strong>Columna de tiempo</strong></td><td><code>hour_bucket</code> (o su alias si lo cambió de nombre)</td></tr><tr><td><strong>Clave primaria</strong></td><td><code>device_id</code>, <code>hour_bucket</code>, <code>sensor_name</code>, <code>event_id</code></td></tr><tr><td><strong>Particionar por</strong></td><td><code>DATE(hour_bucket)</code></td></tr><tr><td><strong>Modo de escritura</strong></td><td><code>anexar</code></td></tr></tbody></table>

La clave primaria debe incluir las cuatro columnas de la clave natural de la función. Usar solo `device_id` y `hour_bucket` provocará violaciones de la clave primaria, porque cada dispositivo tiene varios sensores que emiten en el mismo intervalo. `anexar` es el modo de escritura correcto cuando la programación coincide con el tamaño del bucket, porque cada ejecución produce buckets nuevos que nunca se han escrito antes. Use `upsert` solo si sus ejecuciones se superponen (por ejemplo, un intervalo de 15 minutos programado cada 5 minutos).

#### Programación

La cadencia de programación debe ser igual al valor del intervalo. Luego, cada ejecución lee exactamente la cantidad de datos de un bucket, sin superposición ni huecos.

| Tamaño del bucket | Expresión de programación | Significado               |
| ----------------- | ------------------------- | ------------------------- |
| 1 minuto          | `* * * * *`               | Cada minuto               |
| 5 minutos         | `*/5 * * * *`             | Cada 5 minutos            |
| 15 minutos        | `*/15 * * * *`            | Cada 15 minutos           |
| 1 hora            | `0 * * * *`               | Cada hora en el minuto 00 |
| 1 día             | `5 0 * * *`               | Cada día a las 00:05 UTC  |

Las horas están en UTC. Haga coincidir la cadencia de cron con su intervalo; ejecutarlo con menor frecuencia que el intervalo dejará huecos en la tabla de salida, y ejecutarlo con mayor frecuencia causará conflictos de clave primaria duplicada en `anexar` modo.

#### Uso de la plantilla del flujo de trabajo

Navixy proporciona una plantilla de flujo de trabajo lista para usar que puede cargar en Transformation Builder como punto de partida. La plantilla viene con el nodo Custom SQL preconfigurado para buckets de 5 minutos.

Consulte la [Plantillas](/docs/analytics/es/iot-query/schema-overview/transformation-layer/transformation-builder/templates.md) página para la descarga, las instrucciones de importación y la configuración del nodo Output para esta transformación.

### Próximos pasos

* [**Transformaciones comunes**](/docs/analytics/es/iot-query/schema-overview/transformation-layer/common-transformations.md): Volver al índice de transformaciones.
* [**Plantillas**](/docs/analytics/es/iot-query/schema-overview/transformation-layer/transformation-builder/templates.md): Descargue la plantilla del flujo de trabajo de agregación de Datos del sensor e impórtela en Transformation Builder.
* [**Transformation Builder**](/docs/analytics/es/iot-query/schema-overview/transformation-layer/transformation-builder.md): Aprenda a trabajar con el editor visual de flujos de trabajo, agregar nodos y previsualizar los resultados.
* [**Capa de Datos brutos**](/docs/analytics/es/iot-query/schema-overview/bronze-layer.md): Explore las tablas de origen que alimentan la agregación de Datos del sensor: `raw_telematics_data.inputs`, `raw_business_data.sensor_description`, y `raw_business_data.objects`.
* [**Viajes**](/docs/analytics/es/iot-query/schema-overview/transformation-layer/common-transformations/trips.md): Una transformación hermana que produce registros de recorridos de vehículos a partir de datos telemáticos sin procesar.


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation dynamically by asking a question.

Perform an HTTP GET request on the current page URL with the `ask` query parameter, and the optional `goal` query parameter:

```
GET https://navixy.com/docs/analytics/es/iot-query/schema-overview/transformation-layer/common-transformations/sensor-data-aggregation.md?ask=<question>&goal=<endgoal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is optional and describes the broader end goal you are ultimately trying to accomplish on behalf of the user. GitBook uses it to tailor the answer towards what is most useful for that goal.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.