> For the complete documentation index, see [llms.txt](https://navixy.com/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://navixy.com/docs/analytics/es/dashboard-studio/writing-sql-queries.md).
# Escribir consultas SQL
Escriba consultas PostgreSQL optimizadas para visualizaciones de Dashboard Studio. Conozca los patrones de acceso a datos, la selección de capas y las prácticas recomendadas de rendimiento
Dashboard Studio usa SQL para recuperar datos de los esquemas de IoT Query. Usted escribe SQL en dos contextos: los editores de panel, donde las instrucciones alimentan las visualizaciones, y el Editor de SQL independiente para la exploración de datos. Esta página explica cómo escribir SQL eficaz para ambos contextos, con énfasis en los requisitos de visualización, ya que tienen restricciones estructurales específicas.
### Dónde se usa SQL
Dashboard Studio ofrece dos entornos de SQL para distintos propósitos. Entender cuándo usar cada uno le ayuda a trabajar con más eficiencia.
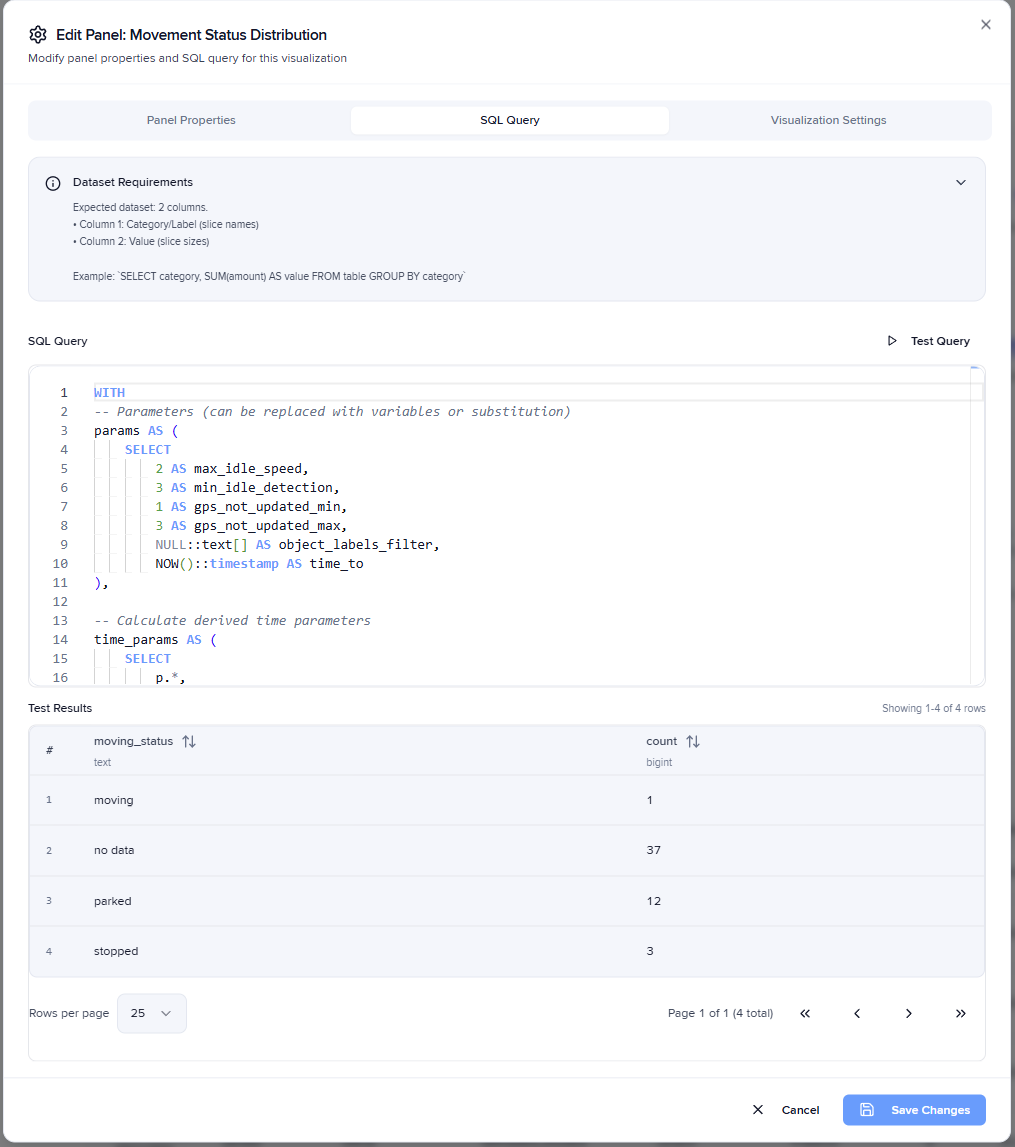
[**Consultas de visualización**](#how-to-write-sql-for-visualizations) alimentan paneles individuales en los reportes. Usted escribe estas instrucciones en la pestaña de Consulta SQL del editor del panel. **Consulta SQL** pestaña. Cada panel ejecuta una instrucción que debe devolver datos con una estructura específica que coincida con el tipo de visualización. Estas instrucciones se ejecutan cuando los reportes cargan o se actualizan, por lo que el rendimiento importa para la experiencia del usuario. El SQL de visualización no puede modificar datos; todas las instrucciones se ejecutan como operaciones SELECT de solo lectura contra los esquemas de IoT Query.
**Reportes** Los reportes usan el mismo enfoque de SQL de visualización que los paneles del dashboard. Un reporte ejecuta una consulta que alimenta tres vistas al mismo tiempo: la tabla de datos, el gráfico y el mapa de ubicación. La instrucción debe devolver todas las columnas necesarias en los tres componentes, así que incluya juntas las columnas de coordenadas, tiempo y métricas en un solo SELECT.
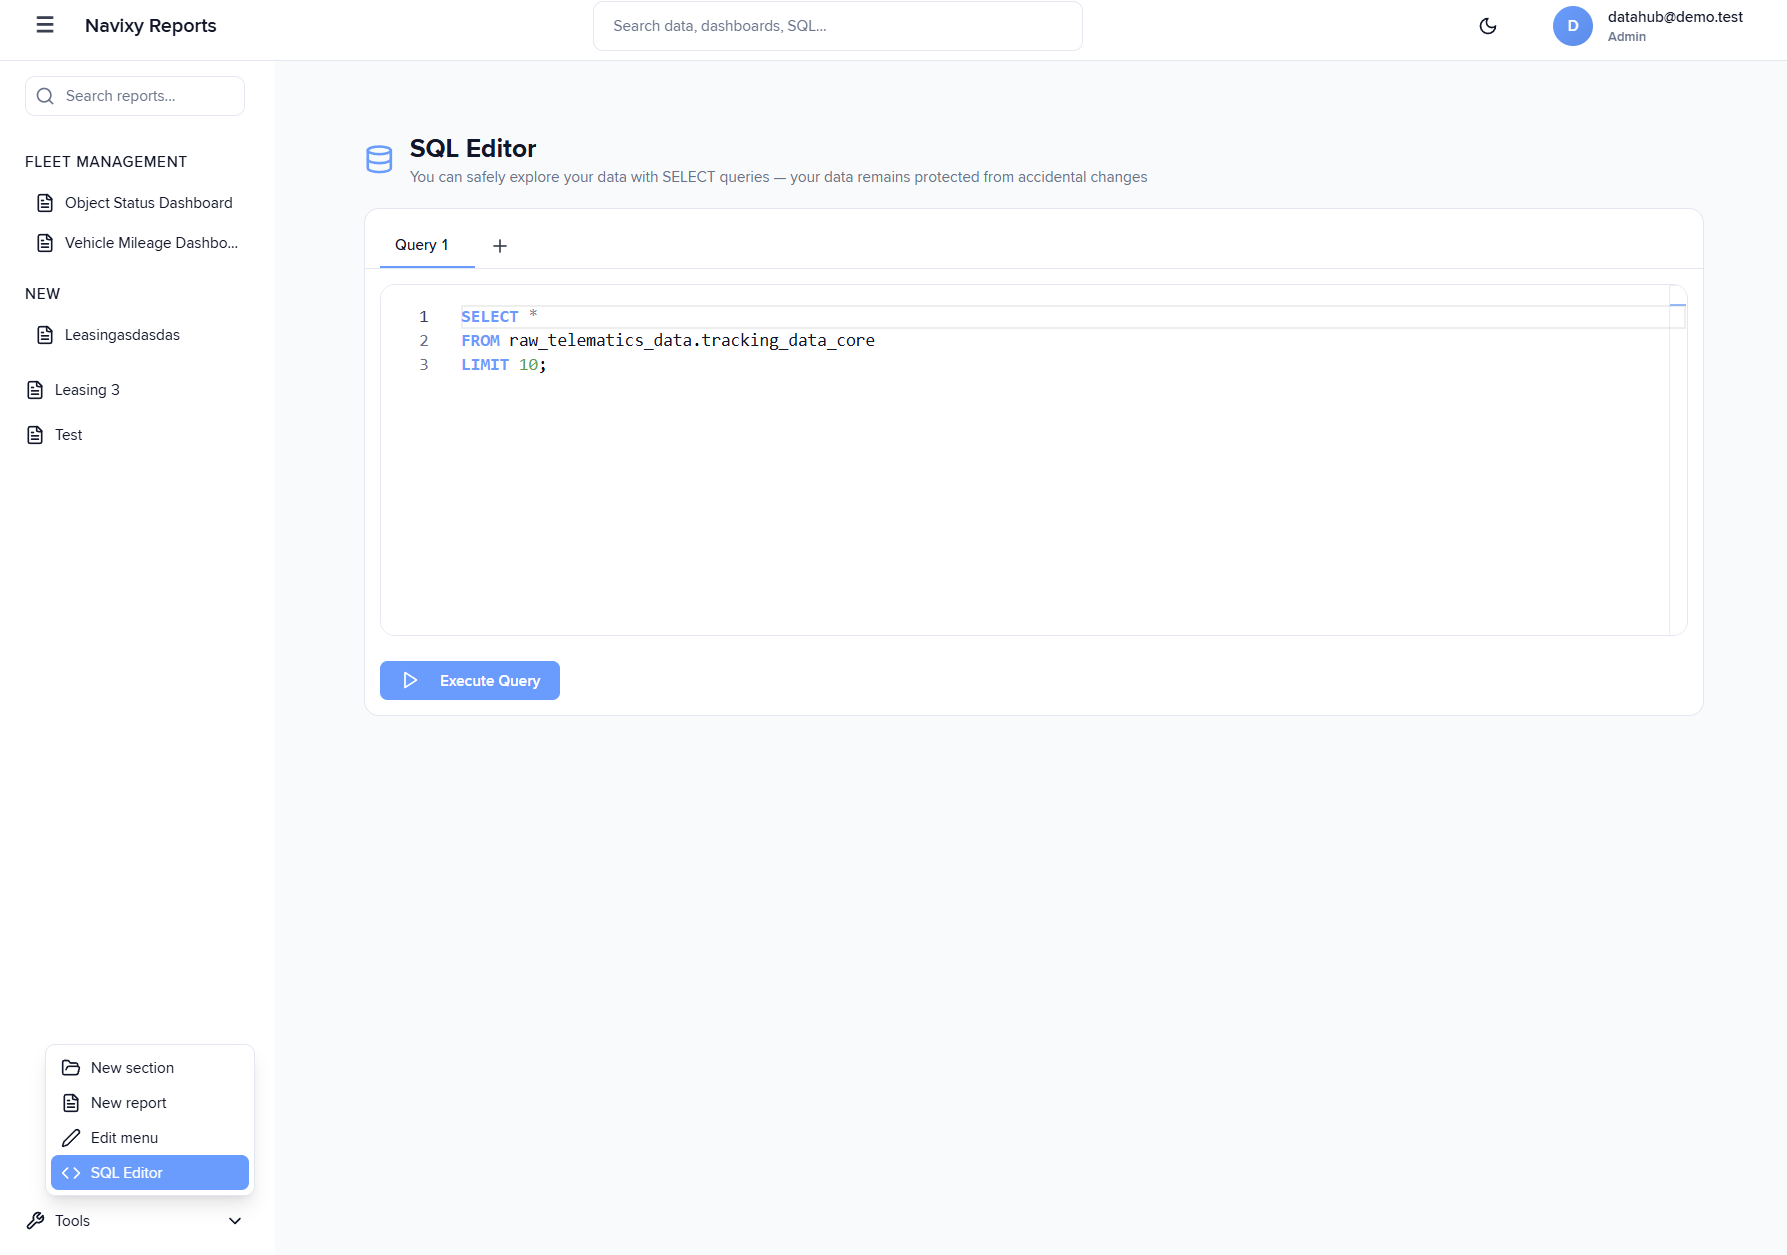
[**Editor de SQL**](#how-to-use-the-sql-editor) admite la exploración y exportación de datos. Acceda al Editor SQL desde la barra lateral izquierda, en Herramientas. Escriba cualquier instrucción SELECT para examinar la estructura de los datos, validar supuestos o exportar los resultados como CSV. El Editor SQL muestra tablas completas de resultados con ordenamiento de columnas y proporciona métricas de ejecución. Use esto para probar la lógica antes de agregar SQL a los paneles de visualización, o para extracción de datos ad hoc que no necesita visualización.
{% hint style="info" %}
**La diferencia clave**: el SQL de visualización debe coincidir con estructuras exactas de columnas, mientras que las instrucciones del Editor SQL pueden devolver cualquier formato de resultado. Pruebe primero la lógica compleja en el Editor SQL y luego adáptela para visualizaciones.
{% endhint %}
### Cómo escribir SQL para visualizaciones
El SQL de visualización debe devolver cantidades específicas de columnas y tipos de datos. Dashboard Studio no puede renderizar un gráfico de barras a partir de tres columnas ni una tarjeta de estadísticas a partir de datos de texto. Consulte la sección Requisitos del conjunto de datos en la pestaña Consulta SQL para ver exactamente qué espera la visualización que eligió antes de escribir la instrucción. La tabla siguiente contiene los tipos de visualización admitidos:
| Visualización | Requisito de consulta | Ejemplo |
| -------------------------------------- | ------------------------------ | ----------------------------------------------------------------- |
| [Tarjeta de estadísticas](#stat-tiles) | Un solo valor numérico | `SELECT COUNT(*) FROM schema.table` |
| [Gráfico de barras](#bar-charts) | Dos columnas: categoría, valor | `SELECT column1, COUNT(*) FROM schema.table Grupo BY column1` |
| [Gráfico circular](#pie-charts) | Dos columnas: etiqueta, valor | `SELECT category, SUM(value) FROM schema.table GROUP BY category` |
| [Tabla](#tables) | Cualquier columna | `SELECT column1, column2, column3 FROM schema.table` |
| [Texto](#text-panels) | No se requiere consulta | Markdown, HTML o texto sin formato |
| [Mapas](#maps) | Columnas de latitud y longitud | `SELECT latitude, longitude FROM schema.table` |
Tarjetas de estadísticas
Las tarjetas de estadísticas muestran valores numéricos únicos. Las sentencias deben devolver exactamente una fila con una columna numérica:
{% code title="Viajes totales en el mes actual" overflow="wrap" %}
```sql
SELECT COUNT(*) as value
FROM processed_common_data.Viajes
WHERE trip_start_time >= DATE_TRUNC('month', CURRENT_DATE);
```
{% endcode %}
{% code title="Distancia total recorrida (km)" overflow="wrap" %}
```sql
SELECT ROUND(SUM(trip_distance_meters) / 1000.0, 1) as valor
FROM processed_common_data.Viajes
WHERE trip_start_time >= CURRENT_DATE - INTERVAL '7 days';
```
{% endcode %}
El nombre de la columna no importa; solo que el resultado sea un único valor numérico. Dashboard Studio muestra este valor con el formato que configure en Configuración de visualización.
Gráficos de barras
Los gráficos de barras requieren exactamente dos columnas: categoría (texto o fecha) y valor (numérico). La primera columna se convierte en el eje X, la segunda en la altura de las barras:
{% code title="Viajes por objeto" overflow="wrap" %}
```sql
CON device_owner AS (
SELECT DISTINCT ON (o.device_id) o.device_id, o.object_label
FROM raw_business_data.objects o
WHERE o.is_deleted IS NOT TRUE
ORDENAR POR o.device_id, o.object_id
)
SELECT
d.object_label como categoría,
COUNT(*) as value
DESDE processed_common_data.Viajes t
LEFT JOIN device_owner d ON d.device_id = t.device_id
DONDE t.trip_start_time >= DATE_TRUNC('month', CURRENT_DATE)
Grupo por d.object_label
ORDER BY value DESC;
```
{% endcode %}
Agrupe por una columna de texto. `datos_crudos_de_negocio.Gestión de vehículos.tipo_de_vehículo` contiene un código entero en lugar de un nombre, por lo que agrupar por él etiqueta las barras `1`, `2`, `3`.
El `propietario_del_dispositivo` el bloque de la parte superior no es opcional cada vez que una etiquetas de Objeto con Viajes o eventos. Véase [Cómo unir etiquetas de Objeto](#how-to-join-object-labels).
{% code title="Conteos diarios de Recorrido" overflow="wrap" %}
```sql
SELECT
DATE_TRUNC('day', trip_start_time)::date as category,
COUNT(*) as value
FROM processed_common_data.Viajes
WHERE Recorrido_start_time >= CURRENT_DATE - INTERVAL '30 days'
GROUP BY DATE_TRUNC('day', trip_start_time)
ORDER BY category;
```
{% endcode %}
Usar `ORDER BY` para controlar la secuencia de barras. Ordene por valor para comparaciones jerarquizadas o por categoría para progresiones de series temporales.
Gráficos de pastel
Los gráficos de pastel requieren exactamente dos columnas: etiqueta (texto) y valor (numérico). La primera columna se convierte en etiquetas de las porciones, la segunda determina el tamaño de las porciones:
{% code title="Viajes por zona de inicio" %}
```sql
SELECT
start_zone como etiqueta,
COUNT(*) as value
FROM processed_common_data.Viajes
WHERE trip_start_time >= DATE_TRUNC('month', CURRENT_DATE)
AND start_zone IS NOT NULL
Grupo por start_zone
ORDER BY value DESC
LIMIT 10;
```
{% endcode %}
Agregue cláusulas LIMIT para categorías con muchos valores. Los gráficos circulares con 20 o más segmentos se vuelven ilegibles; lítelos a las 10-15 categorías principales.
Tablas
Las tablas admiten cualquier cantidad de columnas con cualquier tipo de datos. Seleccione las columnas que desea mostrar:
{% code title="Detalles recientes del recorrido" %}
```sql
SELECT
device_id,
hora de inicio del recorrido,
Recorrido_end_time,
REDONDEAR(recorrido_distance_meters / 1000.0, 1) como distance_km,
ROUND(trip_duration_seconds / 60.0) as duration_minutes,
max_speed
FROM processed_common_data.Viajes
WHERE trip_start_time >= CURRENT_DATE - INTERVAL '7 días'
ORDER BY trip_start_time DESC
LIMIT 100;
```
{% endcode %}
Los nombres de columna se convierten en encabezados de tabla. Use alias con espacios para encabezados legibles: `ROUND(trip_distance_meters / 1000.0, 1) as "Distancia (km)"`.
Paneles de texto
Los paneles de texto muestran contenido de Markdown, HTML o texto sin formato. No ejecutan una consulta SQL.
En el **Contenido** pestaña, seleccione una opción debajo de **Modo de contenido**:
* **Markdown** (predeterminado) admite formato como encabezados y enlaces.
* **HTML** representa el marcado sin procesar.
* **Texto sin formato** muestra el contenido exactamente como lo ingresó y no interpreta ningún marcado.
Utilice paneles de texto para los encabezados de sección, las instrucciones o el contexto junto con sus visualizaciones de datos.
Mapas
Los paneles de mapa trazan un marcador por fila. Las sentencias deben devolver una columna de latitud y una columna de longitud:
{% code title="Últimas posiciones de los vehículos" overflow="wrap" %}
```sql
CON device_owner AS (
SELECT DISTINCT ON (o.device_id) o.device_id, o.object_label
FROM raw_business_data.objects o
WHERE o.is_deleted IS NOT TRUE
ORDENAR POR o.device_id, o.object_id
)
SELECT DISTINCT ON (t.device_id)
d.etiqueta_de_Objeto,
t.latitude / 1e7 AS latitude,
t.longitude / 1e7 AS longitude
FROM raw_telematics_data.tracking_data_core t
LEFT JOIN device_owner d ON d.device_id = t.device_id
WHERE t.device_time >= NOW() - INTERVAL '24 hours'
AND t.latitude <> 0 AND t.longitude <> 0
ORDER BY t.device_id, t.device_time DESC;
```
{% endcode %}
`DISTINCT ON` con el correspondiente `ORDER BY` mantiene una fila por dispositivo, la más reciente. Sin él, la consulta traza todos los puntos históricos que el dispositivo haya enviado alguna vez.
Dashboard Studio detecta automáticamente las columnas de coordenadas cuando usan nombres comunes como `latitud`, `latitud`, o `gps_lat` para latitud y `longitud`, `lon`, o `lng` para longitud. Si sus columnas usan nombres diferentes, selecciónelas manualmente en Configuración de visualización.
Las coordenadas deben estar en grados decimales. Cuando una tabla las almacena como enteros escalados, divida por `1e7` como se muestra arriba. Cualquier otra columna que devuelva la instrucción aparecerá en la ventana emergente del marcador.
Las consultas de reportes siguen las mismas reglas estructurales que las consultas de visualización en los paneles del dashboard. Debido a que una sola instrucción impulsa juntos la tabla de datos, el gráfico y el mapa de ubicación, es posible que necesite combinar columnas que en un dashboard se escribirían como consultas separadas de panel. Por ejemplo, una consulta de panel de gráfico de barras que devuelve dos columnas no es suficiente para un reporte que además necesita coordenadas GPS para el mapa de ubicación. Incluya todas las columnas requeridas para cada componente en una sola instrucción. La lógica central de filtrado y JOIN sigue siendo la misma que en las consultas de panel; solo la cláusula SELECT debe ser más amplia.
### Cómo escribir SQL para reportes
Un reporte ejecuta una consulta SQL que impulsa tres componentes simultáneamente: la tabla de datos, el gráfico y el mapa de ubicación. A diferencia de los paneles del dashboard, donde cada panel tiene su propia consulta enfocada, una consulta de reporte debe devolver todas las columnas necesarias para cada componente en una sola instrucción SELECT.
#### Requisitos de columnas por componente
Cada componente del reporte tiene requisitos de columnas específicos. Su consulta debe satisfacer todos los componentes que haya activado.
| Componente | Columnas requeridas | Notas |
| ----------------- | ---------------------------------------------------------------------------- | ----------------------------------------------------------------------- |
| Tabla de datos | Cualquier columna | Todas las columnas devueltas aparecen como columnas de la tabla |
| Gráfico | Al menos una columna de tiempo o de categoría, al menos una columna numérica | Las columnas de los ejes se seleccionan en la configuración del gráfico |
| Mapa de ubicación | Latitud y longitud en grados decimales | Dashboard Studio detecta automáticamente las columnas de coordenadas |
Como la tabla de datos acepta cualquier columna, no impone restricciones adicionales. El gráfico y el mapa de ubicación determinan la mayoría de las decisiones estructurales.
#### Combinar componentes en una sola consulta
Una consulta que devuelve solo las columnas necesarias para un gráfico (dos columnas: categoría y valor) no puede alimentar también un mapa de ubicación. Debe incluir todas las columnas requeridas juntas.
El siguiente ejemplo devuelve columnas para los tres componentes: una columna de tiempo y una columna numérica para el gráfico, columnas de coordenadas para el mapa de ubicación y atributos adicionales que aparecen en la tabla de datos.
```sql
CON device_owner AS (
SELECT DISTINCT ON (o.device_id) o.device_id, o.object_label
FROM raw_business_data.objects o
WHERE o.is_deleted IS NOT TRUE
ORDENAR POR o.device_id, o.object_id
)
SELECT
t.device_id,
d.etiqueta_de_Objeto,
t.device_time,
t.latitude::float / 10000000 AS latitude,
t.longitude::float / 10000000 AS longitude,
t.speed::float / 100 AS speed
FROM raw_telematics_data.tracking_data_core t
LEFT JOIN device_owner d ON d.device_id = t.device_id
WHERE t.device_time >= NOW() - INTERVAL '24 hours'
ORDER BY t.device_time DESC
LIMIT 1000
```
En esta consulta, `device_time` y `velocidad` sirva para el gráfico, `latitud` y `longitud` sirva para el mapa de ubicación, y todas las columnas aparezcan en la tabla de datos.
{% hint style="info" %}
Las tablas telemáticas en bruto almacenan coordenadas y velocidad como enteros escalados. Las coordenadas se dividen entre 10,000,000 (10⁷) para convertirlas a grados decimales, y la velocidad se divide entre 100 (10²) para convertirla a km/h. Aplique estas conversiones en cualquier consulta que lea de `raw_telematics_data` tablas.
{% endhint %}
#### Adaptar consultas de panel de dashboard para Reportes
Cualquier consulta de panel de un dashboard es un punto de partida válido para un reporte. El ajuste necesario depende de qué componentes quiera activar.
Si la consulta del panel ya es una visualización de tabla que devuelve varias columnas, es posible que ya incluya todo lo necesario. Agregue columnas de coordenadas si se requiere el mapa de ubicación.
Si la consulta del panel es un gráfico de barras o una consulta de tarjeta de estadísticas que devuelve resultados agregados, probablemente carece del detalle a nivel de fila necesario para la tabla de datos y el mapa de ubicación. En ese caso, elimine la agregación y trabaje en su lugar con las tablas subyacentes de la capa de Datos brutos o de la capa de transformación.
[Libro de recetas SQL](/docs/analytics/es/example-queries.md) contiene ejemplos de consultas listos para usar para análisis comunes de la flota. Las recetas del libro se pueden adaptar para reportes agregando columnas de coordenadas donde se necesite el mapa de ubicación. La lógica principal de WHERE y JOIN se transfiere directamente; ajuste solo la cláusula SELECT para cubrir todos los componentes requeridos.
### Cómo usar variables globales
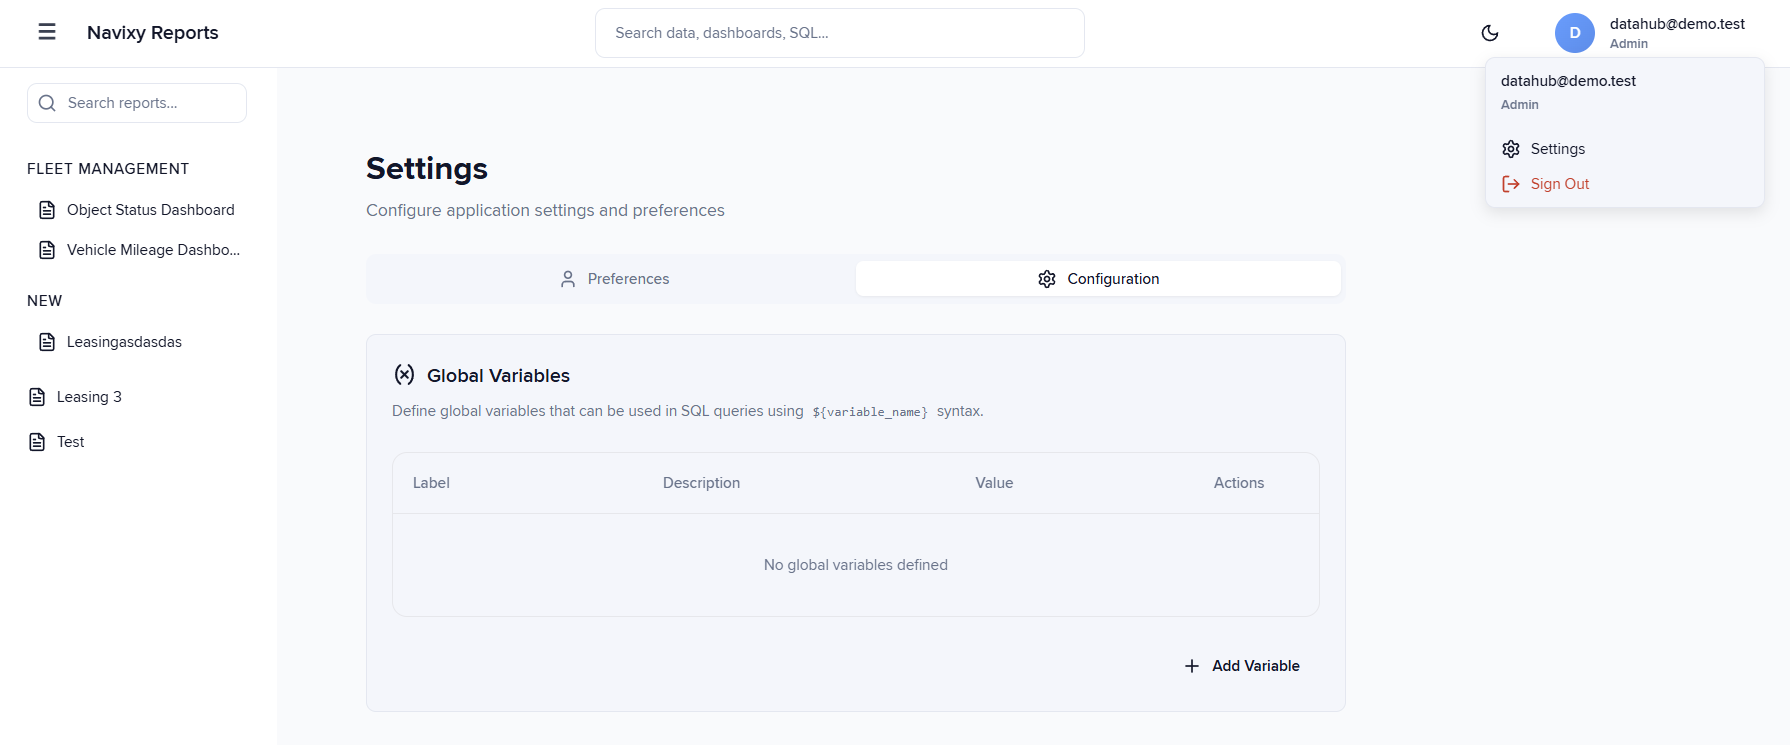
Las variables globales proporcionan valores reutilizables en múltiples instrucciones SQL. Defina las variables en **Ajustes > Configuración > Variables globales**, luego haga referencia a ellas usando `${variable_name}` la sintaxis.
Defina variables para valores que cambian periódicamente pero permanecen consistentes en varios paneles: rangos de fechas de análisis, filtros por tipo de vehículo o valores umbral. Cuando esos valores cambien, actualice la definición de la variable una sola vez en lugar de editar instrucciones SQL individuales.
{% code title="Uso de variables de rango de fechas" %}
```sql
SELECT
DATE_TRUNC('day', trip_start_time)::date as category,
COUNT(*) as value
FROM processed_common_data.Viajes
WHERE recorrido_start_time >= '${analysis_start_date}'::date
AND trip_start_time < '${analysis_end_date}'::date
GROUP BY DATE_TRUNC('day', trip_start_time)
ORDER BY category;
```
{% endcode %}
Las variables almacenan valores de texto. Conviértalas a los tipos apropiados en SQL: `'${variable_name}'::date` para fechas, `'${variable_name}'::integer` para números.
Para parámetros específicos de la instrucción que cambian con frecuencia, puede usar bloques de parámetros CTE al inicio:
```sql
WITH params AS (
SELECT
300 como min_idle_seconds,
10 como max_idle_speed_kmh,
'${analysis_start_date}'::date as date_from,
'${analysis_end_date}'::date as date_to
)
SELECT
e.device_id,
COUNT(*) as idle_count,
ROUND(SUM(e.duration_sec) / 60.0) as total_idle_minutes
FROM processed_common_data.rule_based_Conductor_events e
CROSS JOIN params p
WHERE e.event_type = 'idling_soft'
AND e.device_time >= p.date_from
AND e.device_time < p.date_to
AND e.speed_kmh <= p.max_idle_speed_kmh
AND e.duration_sec >= p.min_idle_seconds
AGRUPAR POR e.device_id
ORDER BY total_idle_minutes DESC;
```
Este patrón combina variables globales (rangos de fechas) con parámetros específicos de la sentencia (umbrales), manteniendo todos los valores ajustables en la parte superior para facilitar el Mantenimiento.
### Cómo unir etiquetas de Objeto
`raw_business_data.objects.device_id` No es único. Un dispositivo puede llevar varios registros de Objeto, porque un dispositivo reasignado entre objetos deja atrás las filas anteriores. Tablas de hechos como `processed_common_data.viajes` encender `device_id` por sí sola, así que una unión simple a `objetos` multiplica cada fila de hechos por el número de registros de objeto coincidentes. Luego, los conteos y las sumas resultan demasiado altos, sin ningún error que se lo indique.
Filtrado en `is_deleted` no es suficiente por sí solo, porque más de un registro puede pasar ese filtro. Primero elija una fila por dispositivo y luego haga la unión con ella:
{% code title="La unión de la etiqueta de objeto" %}
```sql
CON device_owner AS (
SELECT DISTINCT ON (o.device_id) o.device_id, o.object_id, o.object_label
FROM raw_business_data.objects o
WHERE o.is_deleted IS NOT TRUE
ORDENAR POR o.device_id, o.object_id
)
SELECT d.object_label, COUNT(*) AS Viajes
DESDE processed_common_data.Viajes t
LEFT JOIN device_owner d ON d.device_id = t.device_id
DONDE t.trip_start_time >= CURRENT_DATE - INTERVAL '30 days'
AGRUPAR POR d.object_label;
```
{% endcode %}
Usar `LEFT JOIN` en lugar de una unión interna, para que un dispositivo sin un registro de Objeto que sobreviva siga apareciendo en lugar de quedar excluido del resultado.
`processed_common_data.rule_based_Conductor_events` es la excepción. Ya contiene `object_id` y `etiqueta de Objeto`, y sus coordenadas están en grados, así que no necesita ni esta unión ni la `/1e7` conversión.
### Cómo acceder a los esquemas de IoT Query
IoT Query organiza los datos en las Capas de Datos brutos, Transformación y análisis. Las Capas de Datos brutos y Transformación contienen dos esquemas de PostgreSQL cada una, y usted referencia una tabla por el nombre de su esquema en lugar de por la capa. Elegir la capa correcta ahorra tiempo y mantiene SQL claro. Para obtener detalles completos de los esquemas, consulte el [Visión general del esquema de IoT Query](/docs/analytics/es/iot-query/schema-overview.md).
**Capa de Datos brutos** contiene lo que los dispositivos y la plataforma Navixy registraron, en dos esquemas. `raw_telematics_data` contiene datos de Seguimiento, entrada y estado: `raw_telematics_data.Seguimiento_data_core` almacena cada posición de GPS con marcas de tiempo, coordenadas y lecturas de sensores. `datos_brutos_de_negocio` contiene entidades de negocio como `raw_business_data.objects`, `raw_business_data.Gestión de vehículos`, y `raw_business_data.zones`. Utilice la capa de Datos brutos para análisis a nivel de punto, para valores brutos de sensores y para las etiquetas y atributos que vincule a los datos procesados.
**Capa de transformación** almacena entidades procesadas en dos esquemas. `datos_comunes_procesados` contiene las transformaciones que Navixy mantiene, que están disponibles sin configuración: `Viajes`, `datos_de_sensores_por_hora`, `eventos del conductor basados en reglas`, y `input_change_events`. `datos_personalizados_procesados` contiene las transformaciones que usted crea por su cuenta en Transformation Builder. Utilice la capa de transformación para la mayoría de las necesidades de visualización, porque proporciona estructuras listas para el análisis. Vea [Transformaciones comunes](/docs/analytics/es/iot-query/schema-overview/transformation-layer/common-transformations.md) para cada una de las columnas de la tabla.
**Capa de insights** ofrece métricas preagregadas y modelos dimensionales para analíticas complejas. Úselo para estadísticas de toda la flota o análisis multidimensional que de otro modo requerirían uniones complejas con las tablas de la capa de transformación.
{% hint style="warning" %}
Los nombres de las capas Bronze, Silver y Gold describen la arquitectura de medallón que siguen las capas. No son nombres de esquema, y `silver.viajes` no es una tabla que usted pueda consultar. Use los nombres de esquema anteriores.
{% endhint %}
Tablas de referencia que usan `schema.table` formato: `processed_common_data.viajes`, no solo `Viajes`. Incluya filtros de rango de fechas en las cláusulas WHERE para limitar los datos escaneados:
{% code title="Filtre siempre por rangos de tiempo" %}
```sql
SELECT device_id, COUNT(*) as trip_count
FROM processed_common_data.Viajes
WHERE Recorrido_start_time >= CURRENT_DATE - INTERVAL '30 days'
AGRUPAR POR device_id;
```
{% endcode %}
La mayoría de las sentencias SQL filtran por dispositivo, rango de tiempo o ambos. Agregue estos filtros al inicio de las cláusulas WHERE para reducir el volumen de datos procesados.
### Unidades de medición en los resultados de la consulta
IoT Query almacena cada medición en una unidad fija, y Dashboard Studio muestra lo que devuelva la consulta. No convierte los valores al sistema de medición configurado en las Preferencias de la cuenta Navixy, como sí lo hace la app predefinida de Dashboards. Dos personas con Preferencias diferentes ven los mismos números en el mismo panel.
La unidad de cada columna se documenta en la [Visión general del esquema de IoT Query](/docs/analytics/es/iot-query/schema-overview.md), y muchas columnas lo nombran directamente. `distancia del Recorrido en metros` contiene metros, `avg_speed` y `max_speed` mantenga km/h y `altitude_start` y `altitud_final` Mantenga los metros sobre el nivel del mar. Verifique la columna antes de etiquetar un panel.
Convierta en la consulta cuando sus lectores trabajen con otras unidades, y nombre la unidad en el alias de la columna para que el panel se etiquete correctamente:
{% code title="Devolver la distancia en millas en lugar de metros" %}
```sql
SELECT device_id,
ROUND(SUM(trip_distance_meters) / 1609.344, 1) as "Distancia (mi)"
FROM processed_common_data.Viajes
WHERE trip_start_time >= CURRENT_DATE - INTERVAL '7 días'
AGRUPAR POR device_id;
```
{% endcode %}
Divida los metros entre 1,609.344 para obtener millas, km/h entre 1.609344 para obtener mph y los metros entre 0.3048 para obtener pies.
### Cómo usar el editor SQL
Acceda al Editor de SQL desde la barra lateral izquierda, en Herramientas. Úselo para tres propósitos principales: probar la lógica antes de agregarla a los paneles, explorar los esquemas de datos para entender las columnas disponibles y exportar datos que no necesitan visualización.
El editor SQL admite varias pestañas para diferentes sentencias. Escriba SQL en las pestañas, ejecútelo con el botón "Execute Query" y vea los resultados en la tabla de abajo. Los resultados muestran métricas de ejecución (tiempo de ejecución, filas devueltas) y admiten la ordenación de columnas para examinar rápidamente los datos.
Exporte los resultados como CSV usando el botón «Export CSV». Esto funciona para reportes ad hoc o para extracciones de datos para análisis externo. El editor de SQL no tiene límite de filas de resultados, a diferencia del SQL de visualización, que debería devolver conjuntos de datos específicos.
Pruebe el SQL de visualización en el SQL Editor antes de agregarlo a los paneles. Escriba la instrucción, verifique que devuelva las columnas y los tipos de datos esperados, luego cópiela a la pestaña SQL Query del editor del panel. Este flujo de trabajo detecta problemas estructurales antes de que configure los ajustes de visualización.
Patrón de exploración para datos nuevos:
{% code expandable="true" %}
```sql
-- 1. Examinar la estructura de la tabla
SELECT * FROM processed_common_data.trips LIMIT 10;
-- 2. Verifique la cobertura del rango de fechas
SELECT
MIN(trip_start_time) como el más temprano,
MAX(hora_inicio_del_recorrido) como más_reciente,
COUNT(*) como total_recorridos
DESDE processed_common_data.Viajes;
-- 3. Prueba de la lógica de filtrado
SELECT
device_id,
hora de inicio del recorrido,
distancia del Recorrido en metros
FROM processed_common_data.Viajes
WHERE trip_start_time >= '2024-01-01'
AND device_id = 12345
ORDENAR POR trip_start_time;
-- 4. Adaptar para visualización (2 columnas para gráfico de barras)
SELECT
DATE_TRUNC('day', trip_start_time)::date as day,
COUNT(*) as viajes
FROM processed_common_data.Viajes
WHERE trip_start_time >= '2024-01-01'
AND device_id = 12345
GROUP BY DATE_TRUNC('day', trip_start_time)
ORDER BY day;
```
{% endcode %}
### Patrones SQL comunes
La mayor parte del SQL de visualización sigue patrones similares. Copie estas estructuras y ajuste los filtros, las columnas y las agregaciones según sus necesidades específicas.
Conteos de series temporales para el seguimiento de tendencias
```sql
SELECT
DATE_TRUNC('hour', recorrido_start_time) as time_bucket,
COUNT(*) as event_count
FROM processed_common_data.Viajes
WHERE trip_start_time >= CURRENT_DATE - INTERVAL '24 hours'
Grupo BY DATE_TRUNC('hour', trip_start_time)
ORDER BY time_bucket;
```
Clasificaciones de categorías para comparar grupos
```sql
SELECT
columna de categoría,
COUNT(*) as count
FROM schema.table
WHERE filter_conditions
AGRUPAR POR category_column
ORDER BY count DESC
LIMIT 15;
```
Cálculos de métricas para estadísticas agregadas
```sql
SELECT
ROUND(SUM(recorrido_distance_meters) / 1000.0, 1) as total_distance_km,
ROUND(AVG(trip_duration_seconds) / 60.0) as avg_duration_minutes,
COUNT(*) as recorrido_count
FROM processed_common_data.Viajes
WHERE trip_start_time >= DATE_TRUNC('week', CURRENT_DATE);
```
Resúmenes filtrados con múltiples condiciones
```sql
SELECT
device_id,
COUNT(*) as recorridos,
ROUND(SUM(trip_distance_meters) / 1000.0, 1) as total_km
FROM processed_common_data.Viajes
WHERE trip_start_time >= '${period_start}'::date
Y trip_start_time < '${period_end}'::date
Y trip_distance_meters >= 5000
Y trip_duration_seconds >= 600
Grupo POR device_id
HAVING COUNT(*) >= 5
ORDER BY total_km DESC;
```
### Qué hacer cuando SQL falla
Las fallas de ejecución se dividen en tres categorías: discrepancias estructurales con los requisitos de visualización, errores de sintaxis SQL o filtros que no devuelven datos.
#### **Desajustes en la estructura de las columnas**
Ocurren cuando los resultados no coinciden con las expectativas de visualización. Si seleccionó un gráfico de barras pero su SQL devuelve tres columnas, Dashboard Studio no puede renderizarlo. Revise Requisitos del conjunto de datos en la pestaña SQL Query. El gráfico de barras necesita exactamente dos columnas (categoría, valor), así que ajuste su cláusula SELECT:
```sql
-- Incorrecto: tres columnas
SELECT device_id, trip_start_time, COUNT(*) FROM processed_common_data.trips GROUP BY device_id, trip_start_time;
-- Correcto: dos columnas
SELECT device_id, COUNT(*) as trips FROM processed_common_data.trips GROUP BY device_id;
```
#### **Errores de sintaxis de SQL**
Muestre mensajes de error específicos. Los problemas comunes incluyen prefijos de esquema faltantes (`Viajes` en lugar de `processed_common_data.viajes`), errores tipográficos en los nombres de columna o conversión incorrecta de fechas. Pruebe las sentencias en el Editor SQL para ver mensajes de error detallados con números de línea.
#### **Resultados vacíos**
A pesar de una ejecución exitosa, indique que los filtros excluyen todos los datos. Pruebe el SQL sin cláusulas WHERE en el editor de SQL para verificar que la tabla contiene datos; luego agregue filtros de manera incremental para identificar qué condición excluye los resultados esperados.
#### Problemas de rendimiento
Si las sentencias se ejecutan lentamente o agotan el tiempo, agregue filtros de rango de fechas a las cláusulas WHERE. Las operaciones que analizan tablas completas procesan millones de filas innecesariamente:
```sql
-- Lento: sin filtro de fecha
SELECT device_id, COUNT(*) FROM processed_common_data.trips GROUP BY device_id;
-- Rápido: filtro de rango de fechas
SELECT device_id, COUNT(*)
FROM processed_common_data.Viajes
WHERE Recorrido_start_time >= CURRENT_DATE - INTERVAL '30 days'
AGRUPAR POR device_id;
```
Para obtener orientación adicional sobre el rendimiento, consulte [Cómo acceder a los esquemas de IoT Query](#how-to-access-iot-query-schemas) para conocer las mejores prácticas sobre el filtrado y la selección de esquemas.
### Dónde encontrar ejemplos de SQL
El [Libro de recetas SQL](/docs/analytics/es/example-queries.md) proporciona ejemplos completos para análisis telemáticos comunes. Estas recetas demuestran patrones para el análisis de Recorrido, cálculos de visitas a zonas, detección de ralentí y métricas de Flota. Cada receta incluye la instrucción SQL completa, la explicación de la lógica y resultados de ejemplo.
Adapte ejemplos del libro de recetas para visualizaciones ajustando la cláusula SELECT para que coincida con los requisitos de la visualización. Una receta que devuelve registros de recorrido detallados puede convertirse en un gráfico de barras agregando GROUP BY y la agregación COUNT. Una sentencia que calcula métricas por vehículo puede convertirse en un mosaico de estadísticas agregando SUM en todos los vehículos.
Solo necesita:
1. Copie ejemplos de [Libro de recetas](/docs/analytics/es/example-queries.md) al Editor de Dashboard Studio.
2. Pruebe con sus datos reales.
3. Verifique los resultados y luego modifique la cláusula SELECT para su visualización de destino.
La lógica principal de WHERE y JOIN permanece igual; usted ajusta solo la estructura de salida.
Para conocer los detalles del esquema, consulte el [Visión general del esquema de IoT Query](/docs/analytics/es/iot-query/schema-overview.md). Esta referencia explica las tablas disponibles, las definiciones de columnas y las relaciones entre las Capas de Datos brutos, Transformación e Insight.
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation dynamically by asking a question.
Perform an HTTP GET request on the current page URL with the `ask` query parameter, and the optional `goal` query parameter:
```
GET https://navixy.com/docs/analytics/es/dashboard-studio/writing-sql-queries.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is optional and describes the broader end goal you are ultimately trying to accomplish on behalf of the user. GitBook uses it to tailor the answer towards what is most useful for that goal.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.